在现代的软件项目测试领域,不同组织的测试模式可能千差万别。但多数团队仍困在重复的套路里,没认真琢磨过哪些做法可行、哪些该调整。
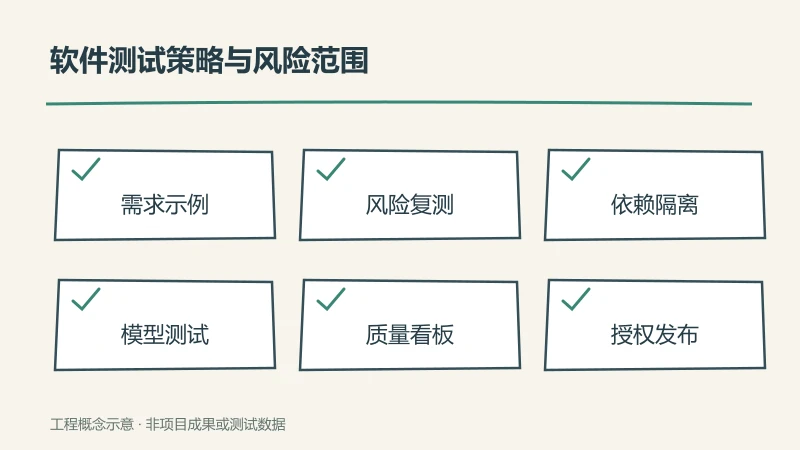
本文提供可按风险试用的测试方法。隔离本地的小实验可以帮助比较效果;涉及共享数据、环境、发布或权限时,仍应按组织流程取得授权,不能因工具免费就省略审批。
先讨论回归测试优先级,再通过组件隔离控制检查范围,最后讨论数据与发布指标。隔离能降低部分验证成本,但不会消除跨组件、共享数据或端到端回归需求。
发布节奏策略
有了这个思路,快速改进的首个步骤步就是优化发布节奏。
程序员写代码前先给例子
密码规则通常写成需求:“至少8个字符,含至少一个大写字母、数字或特殊符号”。但实际中这些要求容易有歧义,开发会按自己理解实现,后来才发现边界情况,或意图和实际行为对不上。比如特殊字符被输入过滤器拒绝,或需求其实是“每种类型至少一个”。
在需求里加例子能减少模糊性,比如列个简单表格,标上“合格/不合格”的密码示例。更好的是,编码前让三个关键角色——开发、客户代表、测试——一起列这个清单。这不能消灭所有缺陷,但能让基础用例跑通,还不用学Ruby、用Gherkin写例子或用Cucumber集成。
在发布节奏里加入RCRCRC
变更位置可以帮助排序测试,但未修改的代码仍可能受依赖、配置、数据和运行环境变化影响,因此不能仅按改动文件划定回归范围。
Karen N. Johnson的RCRCRC启发法就是干这个的——给每次值得人工复测的场景提供不同的测试思路,标出测试员该重点关注的区域。RCRCRC每个字母代表:
-
Recent(近期变更): 近改过的元素;
-
Core(核心):必须正常工作的部分;
-
Risky(风险):团队能说清的风险区域;
-
Configuration-sensitive(配置敏感):依赖配置会变的行为;
-
Repaired(已修复):刚修好的元素;
-
Chronic(顽疾):经常出问题的部分。
用的时候,拿便利贴或数字共享白板列测试思路,详细到普通人10-20分钟能做完。排序(必要时点投票),放看板上,抽卡做到时间用完。发布结束后决定哪些复测、哪些停。工程师可能会说:如果单个组件太差,回归测试范围会受限。
基于组件的策略
通过隔离组件与明确接口,可缩小部分变更的直接验证范围;还需根据依赖关系补契约、集成和关键用户路径回归。
把图形界面和后端分开
很多软件从UI收输入、调API、显示结果。前端要测平台常见错误,比如不同设备尺寸、旋转、系统版本、断网。还要做简单验证测试(力求无效值被拦住),以及几个文本传数据库后正确显示的样例场景。
可以在API或单元层验证更多输入组合,在GUI层保留关键用户路径、交互与可访问性检查。GUI测试数量与深度取决于风险,不能预先认定只需少量。
微服务、单元测试或API检查
现在用Java、C#或Python的组织多少都有点单元测试,但真威力在于隔离测试单个单元。为此得重构代码:把依赖放构造函数里,能传入模拟对象、桩对象和伪对象,逼代码拆成小而可测的部分。
只作数学示例:假设20个单元在同一任务与观察条件下,每个成功概率为0.8,彼此独立,且所有单元都成功才算系统成功,则概率为0.8²⁰≈0.011529,即1.1529%。如果各单元成功概率均为0.999,相同假设下为0.999²⁰≈0.980189,即98.0189%。两组均用20个单元,不混用90%、80%或1000个单元。真实软件可能共享故障、重复调用、存在冗余或恢复,不能把此独立串联模型直接当作实测可靠性。
单独部署组件
Web资源和后端服务能否独立部署,取决于版本契约、缓存、数据库变更和兼容窗口。按组件发布有助于控制影响范围,仍需契约、集成与关键流程回归,并安排失败回滚;拆分部署本身不会消除回归测试。
做基于模型的测试
想象写段代码,让应用随机游走导航。比如社交媒体平台,得先知道应用当前状态:登录页、个人资料页、你的动态流、某条帖子,或编辑评论界面。还要知道每个页面哪些链接有效。然后生成随机步骤和随机文本(填新帖评论),在应用里跳转。
本质是为应用建模型,按模型随机走几步,看模型是否匹配现实。发现错误时,工具回溯找 小复现步骤,再报告。
信息发布策略
公开缺陷年龄、风险覆盖和发布指标,有助于团队讨论资源分配,但指标不会自动提升质量。需避免把缺陷数量当作个人考核或鼓励隐藏问题,重点关注严重性、客户影响和验证证据。
识别并重构复杂模块
大模块容易让人懵,变量太多还相互关联取值。常见情况是维护程序员复制粘贴代码写条件语句两边,只改一边。下一个维护的接需求,只改一处,没意识到代码本该两处都改。
复杂代码藏bug。有些叫“复杂度分析工具”的能告诉你代码有多少循环和分支。
发布待修复bug数或 旧待修复bug
缺陷的严重性、发生概率和用户影响不同,不能只统计数量。可跟踪高风险未修项、待处理时长与修复验证状态,再决定优先级。
发布测试覆盖率可视化
多数公司一开始连功能的可视化都没有,简单如用思维导图分析系统核心功能就行。除了单元测试覆盖率,大部分公司也没衡量软件测试充分性或覆盖度的方法,测试成了黑箱。顺的时候管理层催着快点发功能(暗示砍测试),出大问题就把人关屋里问“这bug咋漏的?”这不仅坑员工,也没给管理层提供决策工具。
可从功能与风险清单开始记录测试覆盖。若使用1—10分自评,必须定义分值含义、证据和评分人;它不是代码覆盖率,也不能把8分解释成80%质量。进一步加入平台、配置、跨功能路径和故障恢复维度,避免单一评分掩盖未测风险。
管理层拿到模型就有选择了:可以建议给薄弱区加测试,或削减非核心功能的测试。之后生产环境发现bug,很可能正是他们选了不投时间测试的地方。你可能还得聊聊问题和调整方案,但对话氛围会大不一样,也轻松些。
RCRCRC用于提示复测思路,不是覆盖充分或可发布的保证;应用时应结合依赖、用户路径与实际风险补充测试。